OPAIRS SQL-Agent: Sechs LoRA-Adapter für industrielle Datenbanken im Vergleich
Sechs LoRA-Adapter, ein 26-Fragen-Katalog aus PostgreSQL-, T-SQL- und Apache-Iceberg-Datenbanken, zwei externe Referenzmodelle: OPAIRS hat den SQL-Agenten systematisch evaluiert. Zwei Granite-Adapter liegen an der Spitze. Für den produktiven Einsatz entscheidet am Ende aber nicht nur die Antwortqualität, sondern auch Geschwindigkeit, Speicherbedarf, Parallelität und der verfügbare Kontext aus ERP-, MES-, PLM- und weiteren industriellen Systemen.
Eine industrielle Datenlandschaft ist selten ein einzelnes System. PostgreSQL-Datenbanken für Instandhaltung und Produktion, T-SQL/MSSQL-Server unter Windows Server für MES und ERP, Apache-Iceberg- und Spark-Datalakes für historische Produktions- und Energiedaten – und darüber oft noch ein SAP-System mit eigenem Tabellenmodell. Ein generisches Sprachmodell kennt keinen dieser Dialekte wirklich gut, und es kennt schon gar nicht die kundenspezifischen Tabellen, Erweiterungen und Namenskonventionen, die in jeder gewachsenen Fertigungs-IT entstanden sind.
Genau dort beginnt das eigentliche Problem industrieller Text-to-SQL-Anwendungen: Es reicht nicht, irgendein syntaktisch korrektes SQL zu erzeugen. Ein Modell muss verstehen, welche Tabellen und Felder tatsächlich zusammengehören, mit welchem SQL-Dialekt es gerade arbeitet – PostgreSQL, T-SQL oder Spark/Iceberg-SQL – und wie die fachlichen Zusammenhänge zwischen Produktion, Instandhaltung, Qualität, Logistik und Engineering abgebildet sind.
OPAIRS hat dafür sechs domänenspezifisch feingetunte LoRA-Adapter gegeneinander getestet. Das Ziel war nicht, das größte Modell zu finden. Gesucht wurde der Kandidat, der als spezialisierter SQL-Agent über PostgreSQL, T-SQL/Windows Server und Apache Iceberg hinweg zuverlässig auf einer einzelnen Grafikkarte beim Kunden betrieben werden kann und sich anschließend in eine breitere industrielle Datenlandschaft integrieren lässt.
Sechs Adapter, derselbe Datensatz, derselbe Benchmark
Alle sechs Adapter basieren auf demselben gehärteten Trainingsdatensatz mit 10.939 Frage-Antwort-Paaren. Unterschiedlich ist das jeweilige Basismodell: Qwen2.5-Coder-7B-Instruct, Qwen3-8B, XiYanSQL-QwenCoder-7B, Mistral-7B-Instruct-v0.3 sowie IBM Granite-4.1-8B und Granite-4.0-H-Tiny.
Bewertet wurden alle Kandidaten gegen denselben 26-Fragen-Katalog. Der Schwerpunkt liegt auf den Datenbanksystemen, die in produktiven Industrieumgebungen tatsächlich nebeneinander laufen: PostgreSQL (CMMS/Instandhaltung, Produktionsdaten), T-SQL unter Windows Server (MES, ERP) sowie Apache-Iceberg-/IOMETE-Datalakes (Produktions- und Energiedaten). Ergänzend deckt der Katalog SAP-Datenmodelle (PM, PP, QM, MM) sowie ABAP ab – eine zusätzliche Stärke des Modells, aber nicht der Kern des Vergleichs. Jede Antwort wurde manuell auf einer Skala von 0 bis 10 bewertet, ab einem Score von 7 gilt eine Antwort als bestanden.
Damit misst der Vergleich nicht, welches Basismodell auf einem allgemeinen öffentlichen SQL-Benchmark am besten abschneidet, sondern welches Modell die für OPAIRS relevanten industriellen Datenbankaufgaben am zuverlässigsten löst – über Dialekte und Systeme hinweg.
Der heutige Katalog bildet dabei erst einen Ausschnitt der späteren Zielumgebung ab. Produktive industrielle Datenlandschaften bestehen selten nur aus einer Datenbank, sondern aus einer Kombination aus PostgreSQL, T-SQL/Windows Server, Apache-Iceberg-Datalakes, ERP-, MES-, PLM- und CMMS-Systemen und weiteren proprietären Fachsystemen. Genau diese Breite soll in den nächsten Validierungsstufen schrittweise abgebildet werden.
Zwei Granite-Adapter liegen an der Spitze
Das Ergebnis ist enger, als die unterschiedlichen Modellarchitekturen vermuten lassen:
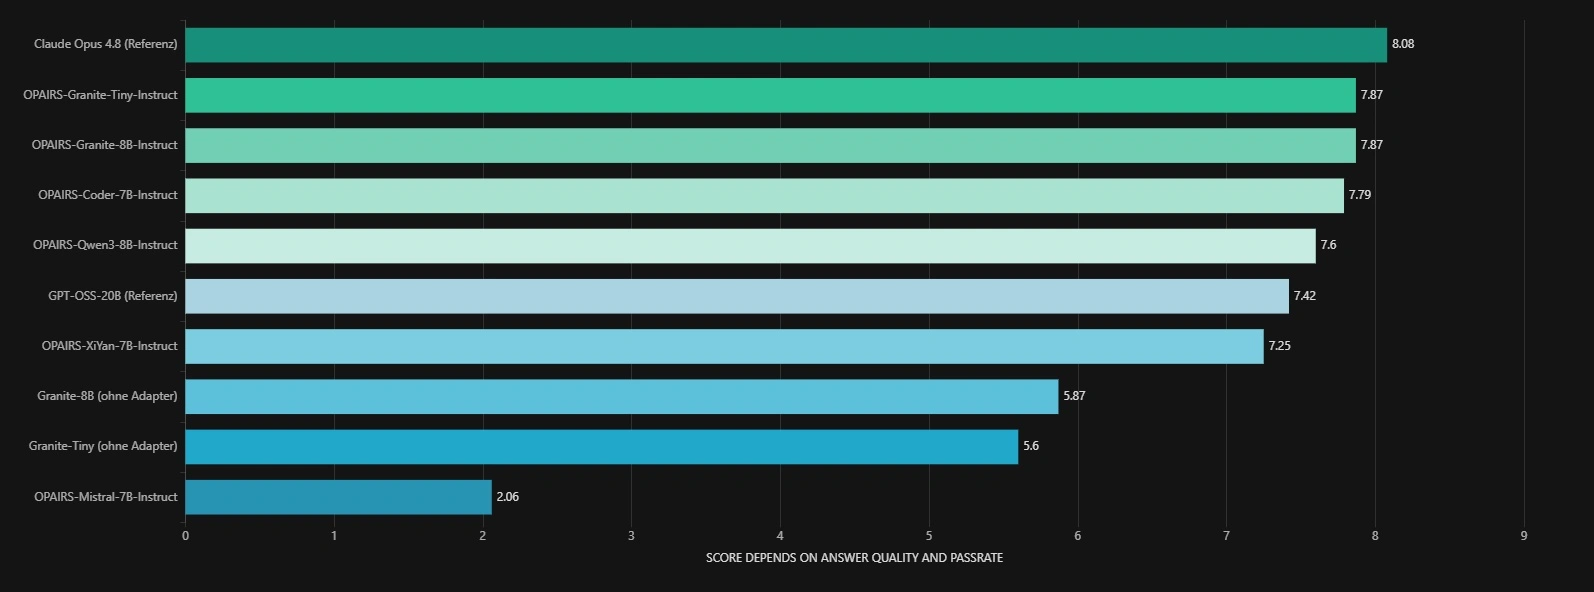
- OPAIRS-Granite-8B-Instruct und OPAIRS-Granite-Tiny-Instruct: jeweils 7,87/10 und 76,9 % Pass-Rate, entsprechend 20 von 26 bestandenen Fragen. Bemerkenswert ist die gleiche Trefferquote trotz sehr unterschiedlicher Architektur: dichtes 8B-Modell auf der einen Seite, Hybrid-MoE mit rund 1 Mrd. aktiven Parametern auf der anderen.
- OPAIRS-Coder-7B-Instruct: 7,79/10 bei ebenfalls 76,9 % Pass-Rate. Der Adapter zeigt die ausgeglichenste SQL-Qualität über PostgreSQL, T-SQL und Spark/Iceberg-SQL hinweg.
- OPAIRS-Qwen3-8B-Instruct: 7,60/10 bei 73,1 % Pass-Rate.
- OPAIRS-XiYan-7B-Instruct: 7,25/10 bei 65,4 % Pass-Rate. Gleichzeitig ist XiYan der schnellste Adapter im ursprünglichen Vergleich.
- OPAIRS-Mistral-7B-Instruct: 2,06/10 und keine bestandene Frage. Selbstkorrektur-Spiralen, Token-Level-Korruption und 16 Antworten, die mitten im Satz abbrechen, schließen den Adapter in der aktuellen Konfiguration für den produktiven Betrieb aus.
Das wichtigste Ergebnis ist damit nicht, dass ein einzelnes Modell deutlich gewinnt. Drei Adapter liegen qualitativ relativ eng zusammen. Die eigentliche Auswahl entscheidet sich deshalb erst im Zusammenspiel aus Antwortqualität, Inferenzzeit und verfügbarem Speicher auf der späteren Zielhardware.
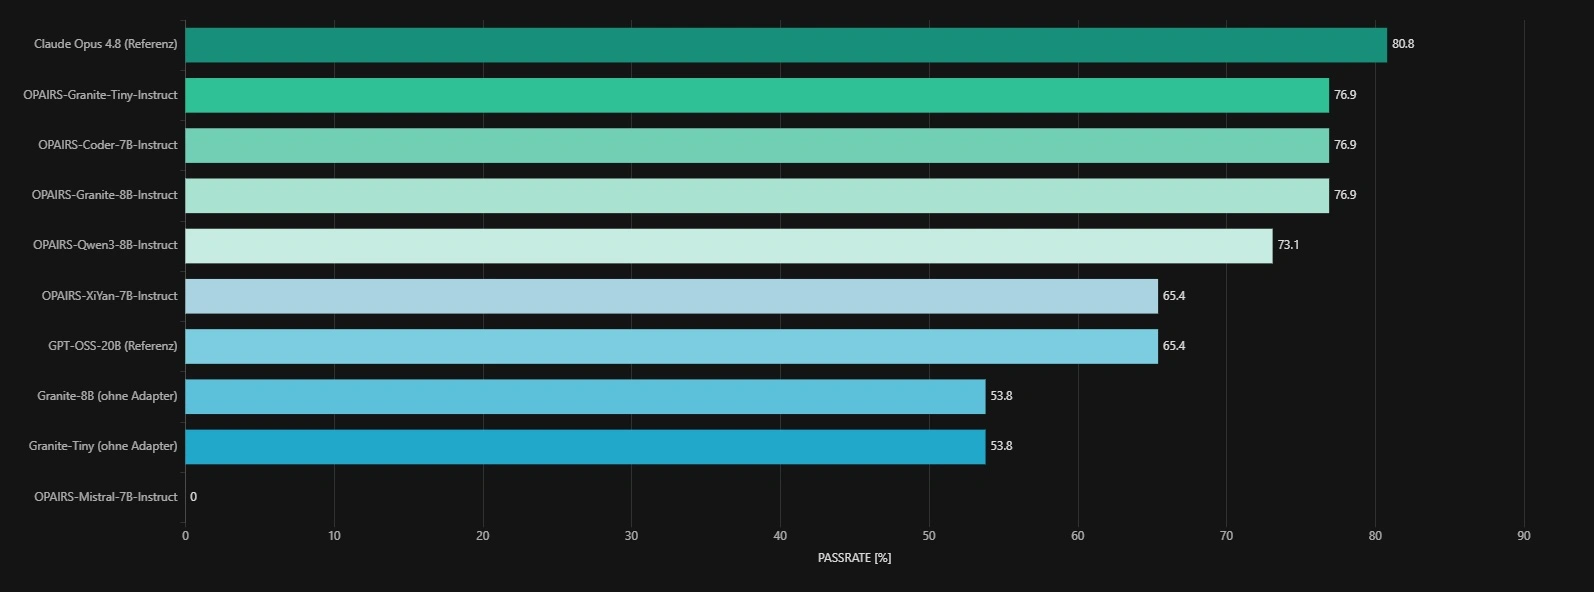
Rangliste: zwei Adapter gleichauf an der Spitze
Granite-8B-Instruct und Granite-Tiny-Instruct erreichen trotz grundverschiedener Architektur exakt denselben Score und dieselbe Pass-Rate über PostgreSQL-, T-SQL- und Iceberg-Fragen hinweg. Coder-7B-Instruct folgt knapp dahinter mit der ausgeglichensten Dialekt-Abdeckung. XiYan-7B-Instruct ist deutlich schneller, aber schwächer in der Trefferquote. Mistral-7B-Instruct wird als einziger Kandidat komplett zurückgestellt. Zum Vergleich stehen zusätzlich Claude Opus 4.8, GPT-OSS-20B sowie beide Granite-Basismodelle ohne Adapter im Chart.
Fine-Tuning schlägt das lokale ungetunte Modell – aber nicht jede externe Referenz
Zur Einordnung wurden zusätzlich zwei Modelle ohne domänenspezifisches SQL-Training gegen denselben Katalog getestet. GPT-OSS-20B erreicht lokal und ungetunt eine Pass-Rate von 65,4 %, die besten eigenen Adapter liegen bei 76,9 % – das Fine-Tuning bringt damit einen messbaren Vorteil von gut 11 Prozentpunkten.
Gegen Claude Opus 4.8 verändert sich das Bild: Das gehostete Flagship-Modell erreicht 80,8 % Pass-Rate und einen Durchschnittsscore von 8,08/10 und liegt damit in diesem Benchmark vor jedem eigenen Adapter – ohne SQL-spezifisches Fine-Tuning. Für die Architekturentscheidung ist dieser Vergleich trotzdem nur ein Referenzpunkt: Ein gehostetes Modell mit API-Kosten pro Token, externer Verarbeitung und ohne Offline-Betrieb erfüllt eine andere Rolle als ein spezialisierter Adapter, der vollständig lokal beim Kunden läuft.
Interessanter ist deshalb ein anderes Ergebnis des Vergleichs: Bei zwei Fragen zu SAP-spezifischen Tabellenverknüpfungen liefern praktisch alle acht getesteten Modelle ihre schwächsten Antworten – inklusive Claude Opus 4.8. Wenn mehrere unabhängige Modellfamilien am selben Punkt scheitern, liegt die Ursache nicht zwangsläufig im Modell. In diesem Fall deutet das Ergebnis auf Lücken im zugrunde liegenden Schema- und Kontextwissen hin – genau diese Lücken werden vor der nächsten Evaluierungsrunde gezielt adressiert.
Nicht das Modell war der größte Hebel, sondern die Sampling-Temperatur
Nach dem ersten Vergleich wurden die beiden Granite-Finalisten zusätzlich auf dem tatsächlichen vLLM-Serving-Stack untersucht. Dabei zeigte sich ein deutlicher Effekt: Ein großer Teil der zunächst beobachteten Qualitätsunterschiede entstand nicht durch das Modell, sondern durch die Inferenzkonfiguration.
Mit der ursprünglichen Temperatur von 0,2 lag die Pass-Rate nur bei rund 61,5 %. Reines Greedy-Sampling mit temp=0.0 erhöht sie bereits auf 76,9 %. Ein leicht angepasstes Setting mit temp=0.1, top_p=0.95 und einer Repetition-Penalty von 1.05 erreicht bei gleicher Pass-Rate Durchschnittsscores zwischen 7,60 und 7,84/10. FP8 gegenüber bf16 verändert das Ergebnis dagegen praktisch nicht.
Noch deutlicher wird der Effekt bei höheren Temperaturen: Ab temp=0.7 sinkt die Pass-Rate bei beiden Architekturen um mehr als 35 Prozentpunkte. Für den produktiven Betrieb ist damit nicht nur entscheidend, welches Modell eingesetzt wird, sondern ebenso, mit welcher Sampling-Konfiguration es betrieben wird.
Der Vergleich mit den jeweiligen Basismodellen ohne Adapter bestätigt gleichzeitig den Effekt des Fine-Tunings: Beide ungetunten Basismodelle erreichen lediglich 53,8 % Pass-Rate. Der größte Zugewinn entsteht insbesondere bei domänenspezifischen Fragestellungen und kundenspezifischen Datenstrukturen.
Zielhardware statt theoretischem Modellvergleich
Ein Benchmark allein entscheidet noch nicht, welches Modell beim Kunden eingesetzt wird. Die Zielhardware für den SQL-Agenten ist bewusst eine einzelne RTX PRO 2000 Blackwell mit 16 GB VRAM. Die Karte benötigt keinen zusätzlichen PCIe-Stromanschluss, belegt nur einen Slot und lässt sich nativ unter Windows betreiben. Das Ziel ist damit keine zusätzliche Rechenzentrums-Infrastruktur – der Fachagent soll in einer normalen Workstation oder einem kompakten Server direkt beim Kunden betrieben werden können.
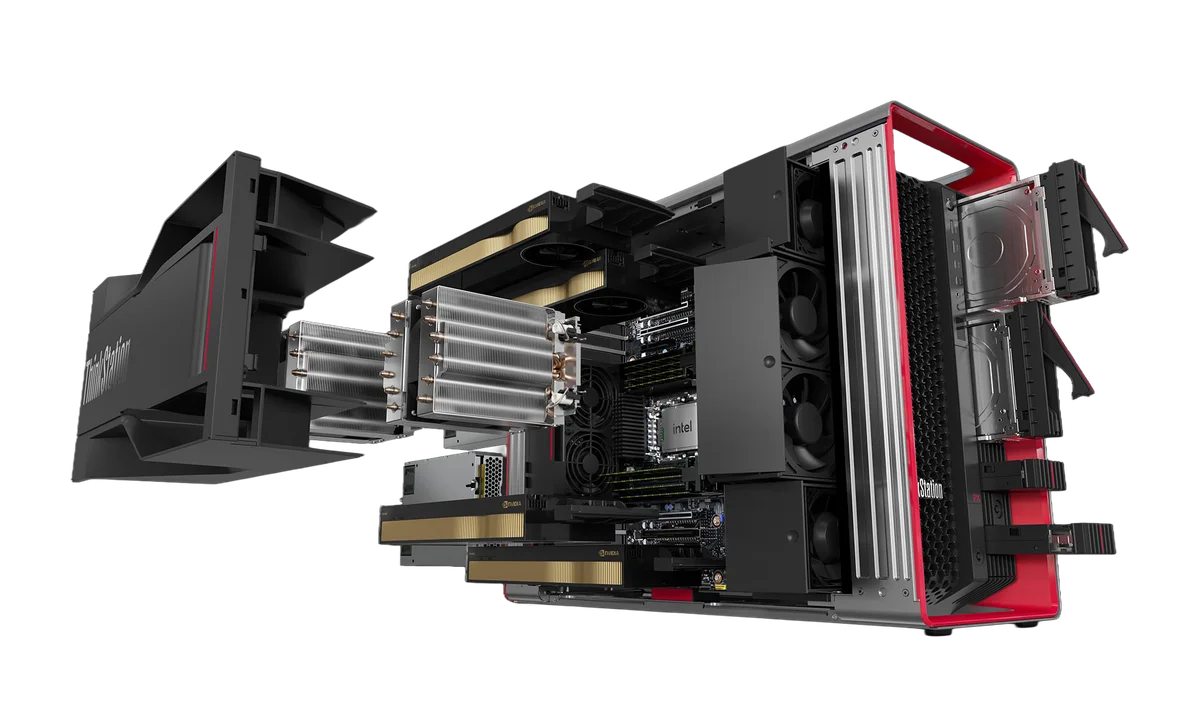
Zielhardware: Einzelkarten-Workstation statt Rechenzentrum
Auf einer Workstation mit einer einzelnen RTX PRO 2000 Blackwell (16 GB VRAM) wurden die beiden Granite-Finalisten erneut verglichen. OPAIRS-Granite-8B-Instruct erreicht 7,84/10 bei rund 6,2 Sekunden durchschnittlicher Antwortzeit, OPAIRS-Granite-Tiny-Instruct 7,60/10 bei rund 1,5 Sekunden – rund viermal schneller bei derselben Pass-Rate von 76,9 %. Der gemessene Qualitätsunterschied liegt innerhalb der Lauf-zu-Lauf-Streuung und ist damit aktuell kein ausreichend belastbarer Grund, die deutlich höhere Inferenzzeit des größeren Modells in Kauf zu nehmen.
Für den Einzelkarten-Rollout fällt die Wahl auf Granite-Tiny
Für den geplanten Einzelkarten-Rollout wird deshalb Granite-Tiny bevorzugt. Der Grund ist nicht nur die rund viermal kürzere Antwortzeit: Das kleinere Modell lässt gleichzeitig mehr Speicher für den KV-Cache frei. Auf derselben 16-GB-GPU können dadurch mehr parallele Anfragen verarbeitet werden, bevor zusätzliche Hardware erforderlich wird – genau diese Reserve ist im produktiven Betrieb wichtiger als ein kleiner Unterschied im Durchschnittsscore.
Granite-8B-Instruct bleibt trotzdem Teil des Stacks: Wenn in einem konkreten Anwendungsfall maximale Antwortqualität klar vor Durchsatz und Parallelität priorisiert wird, bleibt das größere Modell eine sinnvolle Alternative. Die Entscheidung lautet deshalb nicht „kleines Modell ist besser als großes Modell", sondern: Für die vorgesehene Hardware und das erwartete Lastprofil liefert Granite-Tiny derzeit das bessere Gesamtpaket.
Der nächste Qualitätsschritt ist Hardening, nicht automatisch ein größeres Modell
Der Vergleich zeigt gleichzeitig sehr konkret, wo die nächste Entwicklungsarbeit liegt. Ein Teil der Fehler entsteht durch fehlenden Kontext über Tabellen, Beziehungen und fachliche Datenmodelle. Andere Fehler lassen sich automatisiert erkennen und eignen sich damit als Reward-Signal für weitere Trainingsschritte – etwa Aggregationen über bereits vorgefilterte Einzelzeilen oder Filterbedingungen, die innerhalb einer CTE berechnet, im eigentlichen Hauptquery aber nicht angewendet werden.
Daneben gibt es Fehler, die selbst bei externen Referenzmodellen auftreten. Sie erklären den Abstand zwischen den Modellen nicht, bleiben aber trotzdem eigenständige Hardening-Ziele. Und schließlich gibt es reine Deployment-Erkenntnisse wie die hohe Empfindlichkeit gegenüber der Sampling-Temperatur. Keiner dieser Punkte verlangt automatisch nach einem größeren Basismodell – der nächste Qualitätssprung entsteht aus gezieltem Hardening des Datensatzes, besseren Kontextinformationen und einer kontrollierten Inferenzkonfiguration.
RAG war im bisherigen Benchmark noch nicht Bestandteil der Bewertung
Ein wichtiger Punkt bei der Einordnung der bisherigen Ergebnisse: Retrieval-Augmented Generation, kurz RAG, wurde in diesem Benchmark bewusst noch nicht berücksichtigt. Die bisherigen Werte messen damit ausschließlich die Qualität der feintrainierten Modelle und ihrer aktuellen Inferenzkonfiguration.
Das ist wichtig, weil ein produktiver industrieller Agent künftig nicht nur auf sein im Fine-Tuning gelerntes Wissen angewiesen sein soll. Er soll bei Bedarf zusätzlichen Kontext aus den Systemen und Wissensquellen des jeweiligen Unternehmens erhalten – etwa Datenmodelle und Dokumentationen aus PostgreSQL-, MES-, PLM- oder CMMS-Systemen, ebenso wie Tabellenbeschreibungen, technische Dokumentationen, Prozesswissen, Datenbank-Metadaten oder weitere freigegebene Unternehmensinformationen.
Gerade in industriellen IT-Landschaften ist dieser Kontext entscheidend: Zwei Unternehmen können dieselbe Datenbank- oder MES-Software einsetzen und trotzdem völlig unterschiedliche Tabellenstrukturen, Erweiterungen, Namenskonventionen und Prozesslogiken verwenden. Dieses Wissen vollständig in ein Basismodell einzutrainieren ist weder realistisch noch sinnvoll. Genau hier soll RAG eine zusätzliche Ebene bilden: Der Agent erhält zur jeweiligen Anfrage gezielt die Informationen, die für die konkrete Aufgabe benötigt werden. Das Ziel ist nicht, möglichst viel Kontext an das Modell zu übergeben, sondern den richtigen Kontext zum richtigen Zeitpunkt bereitzustellen.
RAG wird mit einem eigenen Validierungskatalog getestet
Auch bei RAG reicht es aus unserer Sicht nicht aus, einzelne Demo-Fragen erfolgreich beantworten zu können. OPAIRS entwickelt deshalb aktuell einen separaten Validierungskatalog für die Retrieval-Schicht. Damit soll systematisch geprüft werden: Welche zusätzlichen Informationen verbessern eine Antwort tatsächlich? Welche Dokumente oder Metadaten werden zuverlässig gefunden? Wann führt zusätzlicher Kontext zu einer besseren SQL-Antwort – unabhängig vom Dialekt – und wann erzeugt Retrieval lediglich mehr Kontext, ohne die fachliche Qualität zu verbessern?
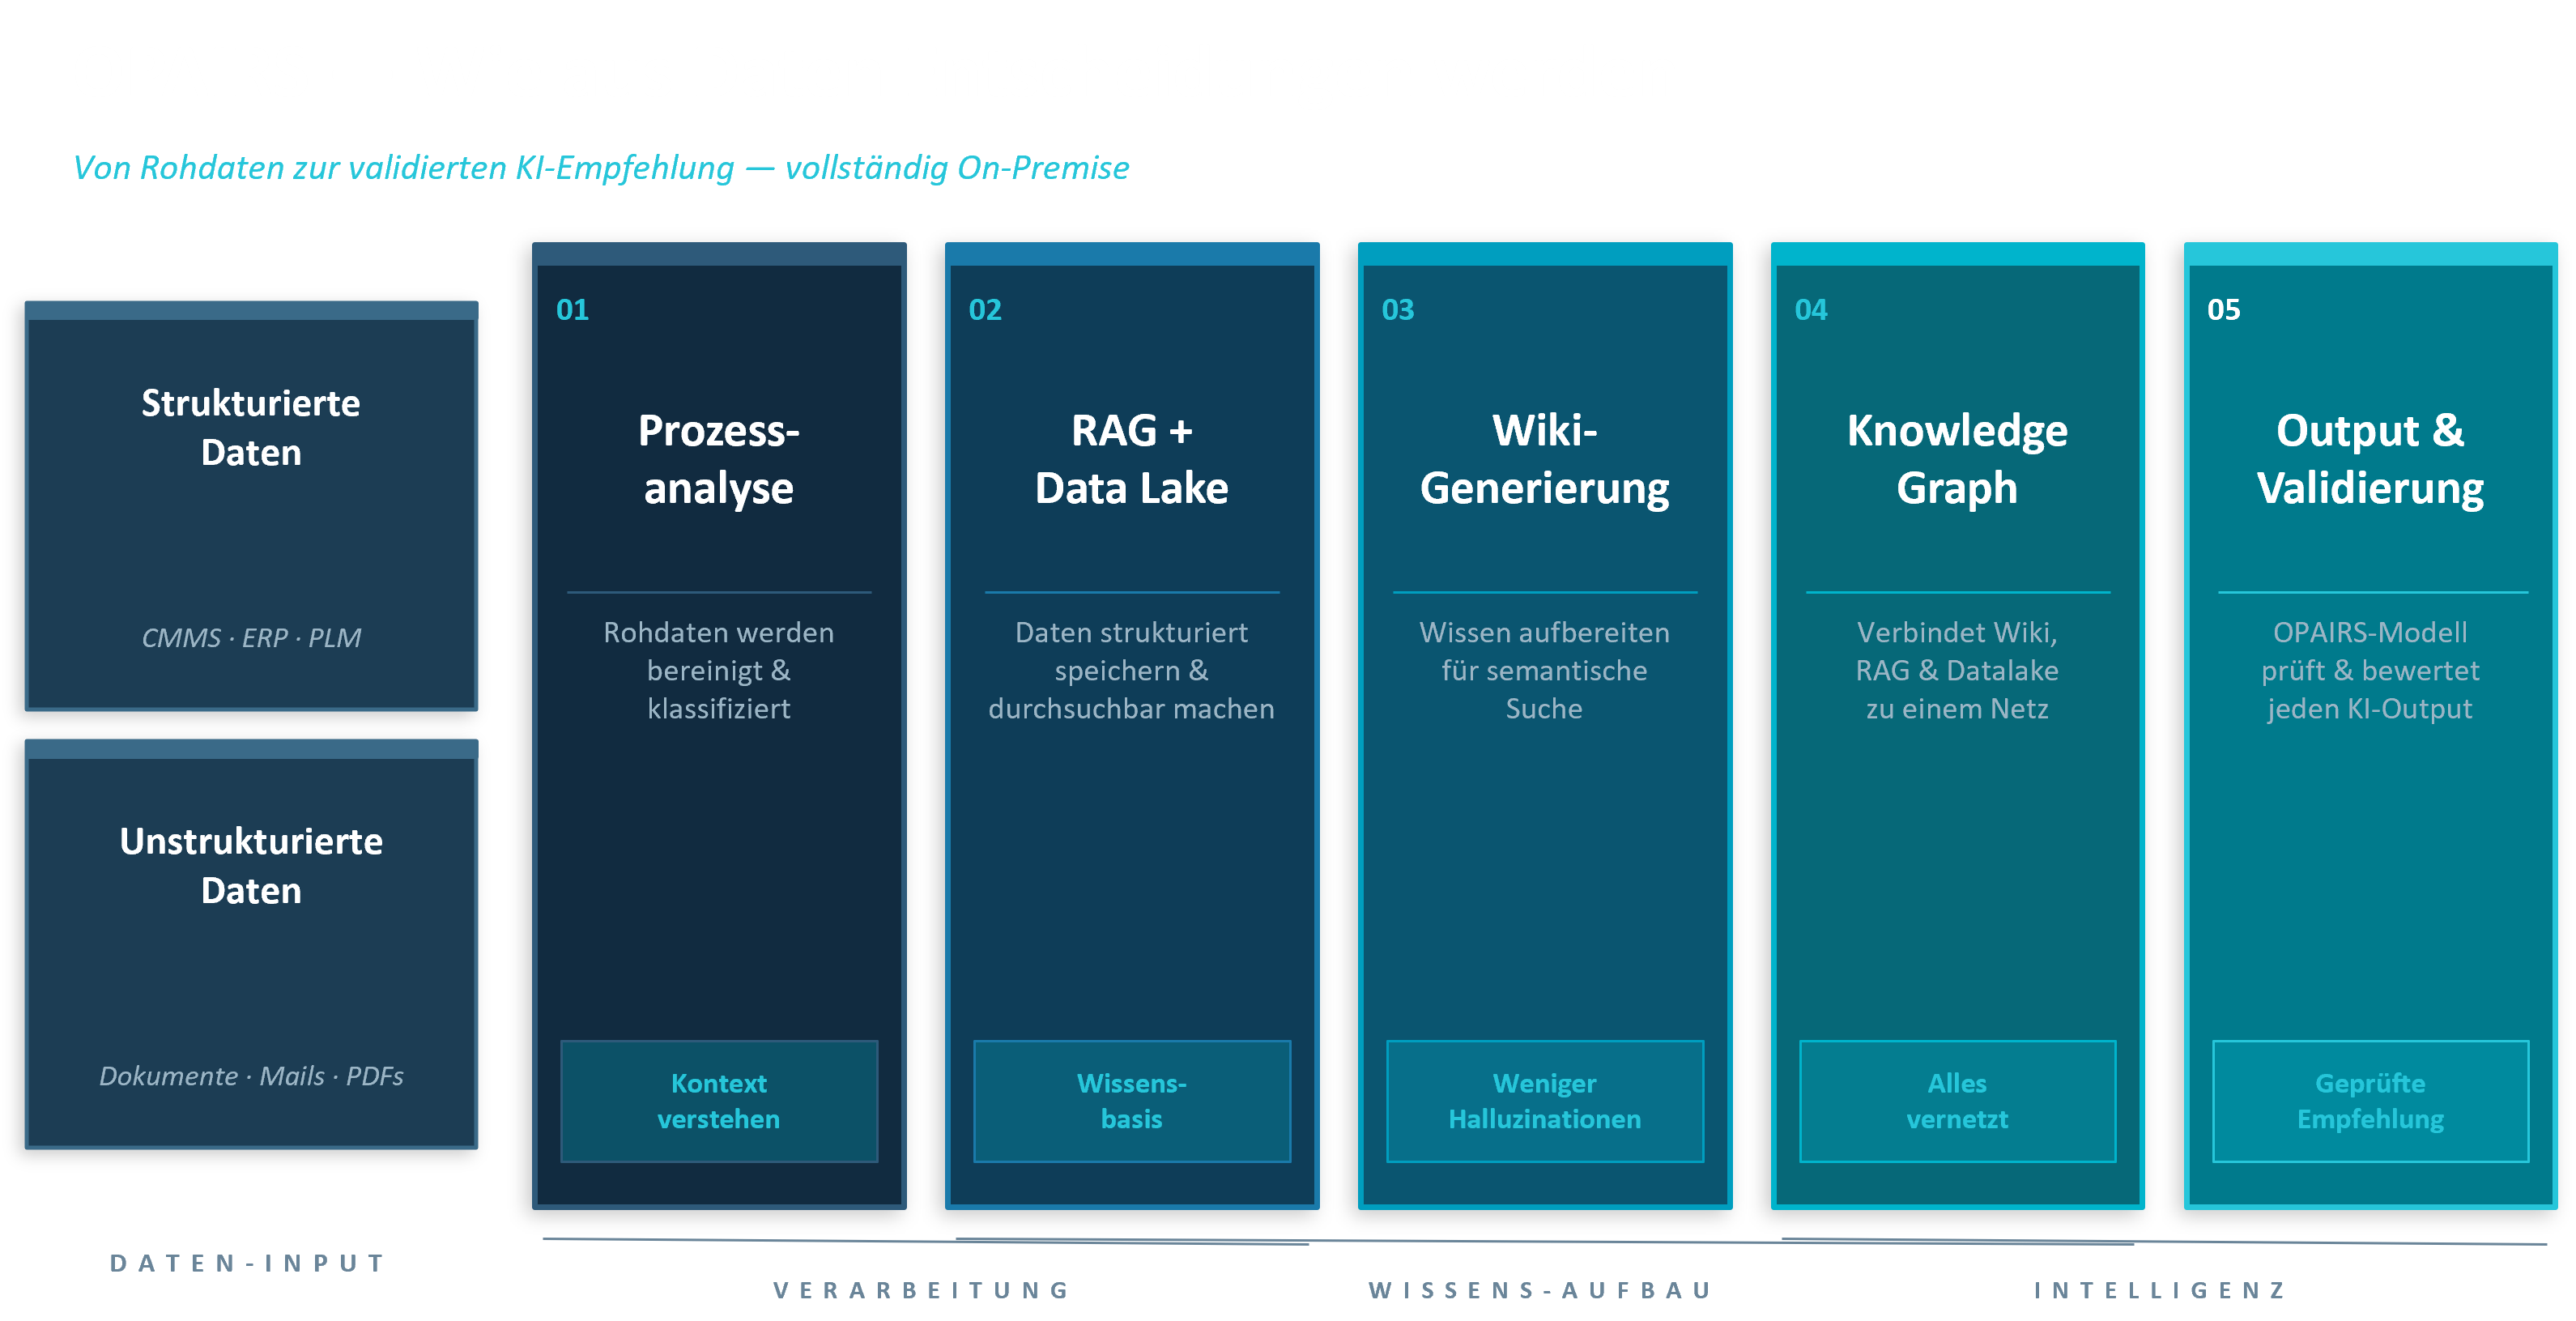
Fine-Tuning und RAG als Zusammenspiel
Die spätere Zielumgebung umfasst nicht nur ein einzelnes System, sondern unterschiedliche industrielle Datenbanken und Quellen: PostgreSQL, T-SQL/Windows Server, Apache-Iceberg-Datalakes, ERP, MES, PLM, CMMS und technische Dokumentationen. Das langfristige Ziel ist eine Architektur, in der Fine-Tuning und RAG unterschiedliche Aufgaben übernehmen: Fine-Tuning vermittelt dem Fachagenten Muster, Dialektbeherrschung und grundlegendes Domänenverständnis, RAG liefert den konkreten, aktuellen und kundenspezifischen Kontext zur jeweiligen Anfrage – orchestriert im selben Multi-GPU-Pipeline-Setup, in dem auch die anderen OPAIRS-Fachagenten laufen.
26 Fragen reichen für die Auswahl – nicht für die Produktionsfreigabe
Der aktuelle Benchmark liefert einen guten ersten Vergleich zwischen den Adaptern. Für eine belastbare Produktionsfreigabe ist ein Katalog mit 26 Fragen allerdings zu klein. Der nächste Schritt ist deshalb ein Validierungskatalog mit mehr als 1.000 Fragen, der die tatsächliche Breite produktiver industrieller Datenlandschaften abdecken soll: unterschiedliche PostgreSQL-, T-SQL/Windows-Server- und Apache-Iceberg-Umgebungen, ERP-, MES- und PLM-Strukturen, Instandhaltungs- und Qualitätsinformationen, kundenspezifische Tabellenmodelle und komplexere Abfrageketten.
Erst auf dieser Größenordnung lässt sich belastbar erkennen, welche Fehler systematisch auftreten und an welchen Stellen eine weitere Fine-Tuning-Runde, besseres Retrieval oder zusätzlicher Kontext notwendig ist. Gleichzeitig entsteht damit die Grundlage, Fine-Tuning und RAG nicht isoliert, sondern gemeinsam zu bewerten. Die entscheidende Frage lautet künftig nicht nur, ob das Modell die Aufgabe lösen kann, sondern ob das Gesamtsystem die richtige Information finden, korrekt einordnen und daraus eine fachlich belastbare Antwort erzeugen kann.
Dafür braucht es reale industrielle Fragestellungen
Genau an diesem Punkt reicht interne Entwicklung alleine nicht aus. Ein allgemein aufgebauter Testkatalog kann viele technische Fehler sichtbar machen, aber nicht vollständig abbilden, wie unterschiedlich reale Produktionsunternehmen ihre PostgreSQL-, MES-, PLM-, CMMS- und ERP-Systeme aufgebaut haben. Deshalb sucht OPAIRS Partner und Kunden, die Interesse haben, diese nächste Entwicklungsstufe gemeinsam zu validieren.
Gesucht werden keine perfekt vorbereiteten Demo-Datensätze. Wertvoll sind gerade reale Fragestellungen aus bestehenden Systemlandschaften: Welche Informationen benötigt ein Produktionsleiter tatsächlich? Wie fragt ein Instandhalter nach historischen Störungen? Wie werden Produktionsaufträge, Materialien, Qualitätsdaten und Maschinenzustände miteinander verknüpft? Welche Beziehungen zwischen den verschiedenen Datenbanken und Systemen sind für eine Antwort entscheidend? Und welche Antworten sind fachlich zwar plausibel, in der betrieblichen Realität aber trotzdem falsch oder unvollständig? Dieses Feedback ist für die weitere Entwicklung entscheidend.
Qualitativ hochwertiges Feedback wird Teil der Optimierung
Das Ziel der Zusammenarbeit ist nicht, möglichst viele Testfragen zu sammeln – entscheidend ist die Qualität des Feedbacks. Für jede relevante Antwort soll nachvollziehbar werden: Was war korrekt? Was war fachlich falsch? Welcher Kontext hat gefehlt? Welche Information hätte das System finden müssen? War das Problem im Modell, im Retrieval, in den vorhandenen Metadaten oder in der Datenquelle selbst?
Genau diese Rückmeldungen können anschließend strukturiert in die nächsten Entwicklungszyklen einfließen. Daraus entstehen neue Evaluierungsfälle, Verbesserungen der Retrieval-Logik, zusätzliche Trainingsbeispiele und gezielte Hardening-Maßnahmen. So entwickelt sich aus einem allgemeinen Fachagenten schrittweise ein System, das reale industrielle Datenlandschaften immer zuverlässiger versteht.
Zwei Wege für die gemeinsame Validierung
Die Validierung kann direkt auf einer lokalen OPAIRS-Installation beim Partner stattfinden. Alternativ können Tests auf der lokalen OPAIRS-Entwicklungsinfrastruktur gegen ein kontrolliertes Abbild oder eine entsprechend vorbereitete Datenstruktur durchgeführt werden. In beiden Fällen bleibt die Datenverarbeitung lokal beziehungsweise unter der Kontrolle des jeweiligen Partners. Die gemeinsam erarbeiteten Ergebnisse fließen direkt in die Weiterentwicklung des Evaluierungskatalogs, der Fine-Tuning-Datensätze und der RAG-Architektur ein.
Für OPAIRS ist das ein zentraler Teil der nächsten Entwicklungsphase: Ein industrieller Agent wird nicht dadurch besser, dass ausschließlich das Basismodell vergrößert wird. Er wird besser, wenn Modell, Kontext, Datenstruktur und fachliches Feedback gemeinsam optimiert werden.
Als Nächstes folgen Produktions- und Maintenance-Agent
Der SQL-Agent ist der erste der spezialisierten Fachagenten, die GPT-OSS-20B innerhalb der OPAIRS-Architektur gezielt ergänzen. Das Prinzip bleibt dabei gleich: Das Hauptmodell übernimmt allgemeine Interaktion und Orchestrierung, spezialisierte Aufgaben werden an kleinere, für ihre jeweilige Domäne feintrainierte Modelle übergeben.
Nach derselben Methodik wie beim SQL-Agenten laufen derzeit die Evaluierungen für den Produktions- und den Maintenance-Agenten: domänenspezifisches LoRA-Fine-Tuning, Bewertung gegen Expertenkataloge und Vergleich mit ungetunten Referenzmodellen. Parallel dazu wird untersucht, wie diese Fachagenten künftig über RAG zusätzlichen Kontext aus ERP-, MES-, PLM-, CMMS- und weiteren industriellen Informationsquellen erhalten können.
Die Ergebnisse werden in den nächsten Insights veröffentlicht. Entscheidend wird dabei nicht nur die Qualität der einzelnen Fachmodelle sein, sondern ihr Zusammenspiel innerhalb der bestehenden Multi-GPU-Orchestrierung mit GPT-OSS-20B, der Retrieval-Schicht und den jeweiligen Unternehmensdaten.
Für technische Zusammenarbeit, gemeinsame Validierung oder Industrieprojekte: office@opairs-systems.com
Weitere Insights
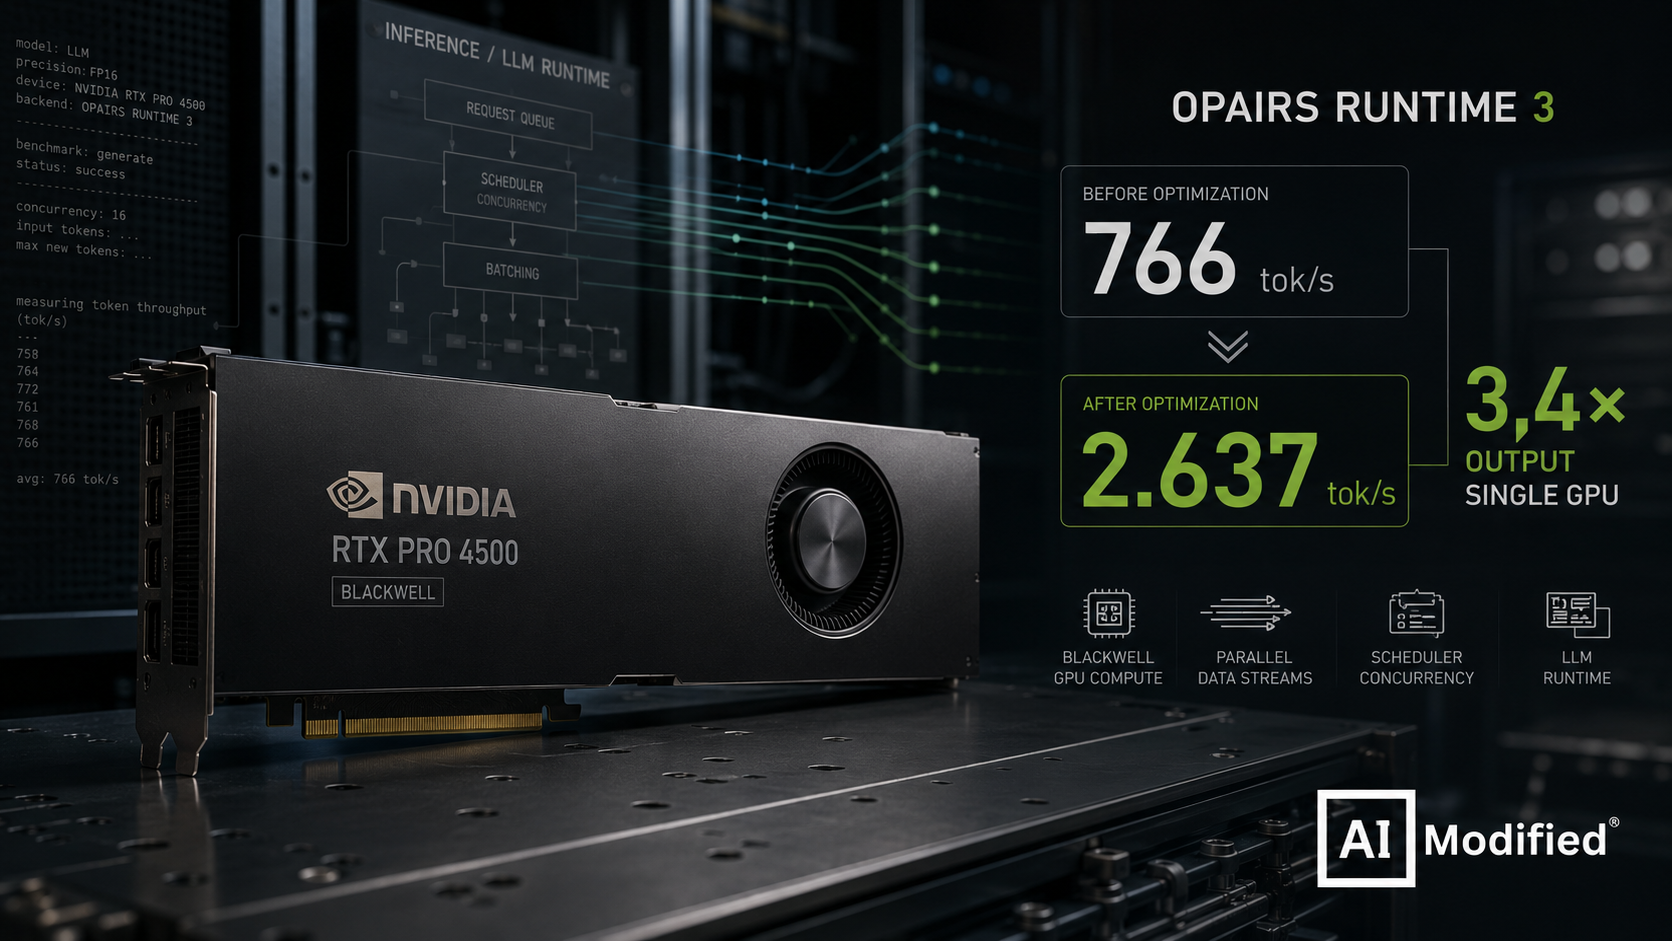
RTX PRO 4500 Blackwell: 3,4-facher LLM-Durchsatz durch Runtime-Optimierung
Gleiche GPU, gleiches Hauptmodell, bis zu 3,4-facher Output: OPAIRS Runtime 3 erhöht den Durchsatz von GPT-OSS-20B auf der RTX PRO 4500 Blackwell auf bis zu 2.637 Token/s. Gleichzeitig zeigen die Tests, warum Qwen3.8-27B den Produktionsstack vorerst nicht übernimmt.
Beitrag lesen
OPAIRS ist Mitglied im NVIDIA Inception program
GPU-beschleunigte LLM-Inferenz on-premise: Was NVIDIA Inception für den OPAIRS-Stack bedeutet, und warum souveräne KI und leistungsstarke Hardware Zusammenspielen müssen.
Beitrag lesen