OPAIRS Forecasting: Selbst gehostete Zeitreihenprognose für die Fertigung
Wie viel Material verbrauchen wir im nächsten Quartal, wann steigt der Energiebedarf, welche Artikel laufen aus? Solche Fragen beantworten Zeitreihenprognosen – bisher meist über Cloud-Dienste, in die Produktionsdaten abfließen. OPAIRS hat einen eigenen Prognose-Dienst gebaut, der vollständig lokal läuft, nur dann ein Modell empfiehlt, wenn es eine einfache Baseline nachweislich schlägt, und sich mit dem SQL-Agenten zu einer durchgehenden Kette verbindet: Daten abfragen, prognostizieren, bewerten.
Fast jede Frage in der Fertigung hat eine zeitliche Dimension: Wie entwickelt sich der Materialverbrauch im nächsten Quartal? Wann steigt der Energiebedarf? Welche Artikel laufen aus, bevor die nächste Bestellung eintrifft? Die Datengrundlage dafür sind Zeitreihen aus ERP, MES, Energiemanagement und Instandhaltung. Prognose-Dienste aus der Cloud verlangen, dass diese Reihen das Haus verlassen – bei Verbrauchs-, Auftrags- und Maschinendaten ist das für viele Fertiger ein Ausschlusskriterium.
OPAIRS hat deshalb einen eigenen Prognose-Dienst entwickelt. Er läuft vollständig lokal, speichert keine Daten und lässt sich auf zwei Wegen nutzen: über das LiteLLM-Gateway, das dann der eine Endpunkt für alle Agenten bleibt, oder direkt als MCP-Server von jedem Agenten, der MCP spricht. Das Ziel war nicht, ein einzelnes Modell zu feiern, sondern einen Dienst, dem man ansieht, wann er seiner Prognose vertrauen darf.
Ein Dienst, mehrere Modelle, ein Endpunkt
Der Dienst bündelt drei Modellfamilien hinter einer Schnittstelle:
- Statistikmodelle (Seasonal-Naive, ETS, Theta, ARIMA): schnell, robust und bei kurzen Reihen oft schwer zu schlagen.
- Chronos-Bolt: ein vortrainiertes Foundation-Modell für Zeitreihen, das ohne Training auf den eigenen Daten Prognosen liefert.
- TiRex-2 von NXAI: ein weiteres Foundation-Modell, ebenfalls lokal betrieben.
Die Modelle liegen als Gewichte im eigenen Haus, es gibt keine Downloads zur Laufzeit. Der Dienst ist zustandslos: Die Zeitreihen kommen mit der Anfrage, das Ergebnis geht zurück, nichts bleibt gespeichert. Angesprochen wird er über REST oder als MCP-Server, wahlweise über LiteLLM oder direkt, ohne dass dafür etwas am Dienst geändert werden muss. Pipes und Agenten enthalten damit nur Logik, die Modelle selbst laufen im Dienst.
Ein Modell wird nur gewählt, wenn es die Baseline schlägt
Welches Modell am besten passt, hängt von der Reihe ab. Der Dienst entscheidet das nicht nach Bauchgefühl, sondern per Rolling-Origin-Backtest: Alle Kandidaten sagen mehrere zurückliegende Abschnitte der Reihe voraus, die der Dienst bereits kennt, und werden an den tatsächlichen Werten gemessen. Als Maßstab dient eine einfache Baseline, der saisonale Vorjahreswert (Seasonal-Naive). Kennzahl ist die relative Abweichung: Ein Wert unter 1,0 bedeutet, dass das Modell besser ist als die Baseline.
Schlägt kein Modell die Baseline, liefert der Dienst trotzdem eine Prognose, markiert sie aber ausdrücklich als nicht validiert und fügt eine Warnung hinzu. Er behauptet keine Qualität, die er nicht gemessen hat. Für Anwender ist das der wichtigste Unterschied zu einer Prognose, die immer gleich selbstsicher aussieht.
Schlagen mindestens zwei Modelle die Baseline, kommt ein weiterer Kandidat dazu: der Mittelwert der beiden besten. Er wird wie jedes andere Modell im Backtest bewertet und ersetzt das beste Einzelmodell, wenn er nur unwesentlich schlechter abschneidet. Der Hintergrund: Bei wenigen Backtest-Fenstern sind die Ränge verrauscht, und Mittelwerte verallgemeinern meist besser als die einzelne Auswahl.
Benchmark auf zwölf öffentlichen Zeitreihen
Zur Einordnung hat OPAIRS den Dienst auf zwölf öffentlichen Zeitreihen getestet: monatlich, quartalsweise, wöchentlich, täglich und stündlich, darunter Passagierzahlen, Autoverkäufe, Sonnenflecken, Temperaturen, Bierproduktion, Benzinverbrauch und Transformatordaten. Von jeder Reihe wurde das Ende zurückgehalten, der Dienst hat nur mit den übrigen Daten prognostiziert und wurde danach mit den echten Werten verglichen (relative Abweichung gegenüber der Baseline, kleiner ist besser):
- Automatische Wahl mit Ensemble: 0,713, in 11 von 12 Datensätzen besser als die Baseline.
- Automatische Wahl ohne Ensemble: 0,757.
- TiRex-2 allein: 0,731.
- Chronos-Bolt allein: 0,768.
- Theta: 0,831.
- ETS: 0,952.
Zwei Dinge stechen heraus. Erstens ist kein Modell überall am besten: Die Foundation-Modelle sind im Mittel stärker als ETS und Theta, aber bei einzelnen Reihen liegt ein Statistikmodell vorn. Genau deshalb lohnt sich die Wahl per Backtest. Zweitens verhindert das Ensemble vor allem Ausreißer: Bei den wöchentlichen Benzindaten liegt die automatische Wahl bei 0,98, mit dem allein gewählten Theta-Modell wären es 1,23.
Was die Zahlen nicht belegen
Zwölf Datensätze mit je einem Rückhaltezeitraum sind eine kleine Stichprobe. Unterschiede unter etwa 0,03 sind Rauschen. Außerdem wurde die Ensemble-Regel nach einem ersten Lauf auf denselben Daten entworfen, auch wenn der Toleranzfaktor vorab festgelegt und nicht nachträglich angepasst wurde; die Werte sind deshalb leicht optimistisch. Bei einer reinen Rauschreihe (tägliche Geburtenzahlen) schlägt kein Modell die Baseline, und der Dienst weist das aus, statt eine Güte vorzutäuschen. Und: Alle Daten sind öffentlich. Eine Prüfung mit echten Produktionszeitreihen steht noch aus.
Läuft auf reiner CPU
Der Prognose-Dienst braucht keine Grafikkarte. Die GPUs bleiben für die Sprachmodelle reserviert, die Zeitreihenmodelle laufen auf der CPU des Servers. Die Statistikmodelle rechnen pro Reihe auf einem Kern und werden bei größeren Anfragen auf mehrere Prozesse verteilt, die Foundation-Modelle nutzen mehrere Kerne gleichzeitig. Auf einem Server mit 80 CPU-Kernen dauert eine Anfrage mit 50 Zeitreihen inklusive Backtest und Modellwahl rund 17 Sekunden, mit 200 Zeitreihen rund 35 Sekunden – das entspricht grob 340 Reihen pro Minute. Beim Start lädt der Dienst alle Standardmodelle vor (rund 27 Sekunden), damit die erste echte Anfrage keinen Kaltstart zahlt.
Zusammenspiel mit dem SQL-Agenten
Die meisten Zeitreihen liegen bereits in den Datenbanken, die der OPAIRS SQL-Agent erschließt: Verbrauchs-, Auftrags- und Maschinendaten in PostgreSQL, T-SQL oder Apache Iceberg. Daraus ergibt sich eine durchgehende Kette: Der SQL-Agent holt die Reihe aus dem Quellsystem, der Prognose-Dienst rechnet Prognose und Backtest, und das Ergebnis kommt mit Modellwahl, Güte und Warnungen zurück in den Chat. Eine Beispiel-Pipe für OpenWebUI zeigt das bereits: Sie liest die Daten aus einem SQL-Block oder einer CSV und ruft den Dienst über LiteLLM auf. Sie ist als Test- und Beispielintegration gedacht, nicht als fertiges Produkt.
Mehr zum SQL-Agenten und zu den sechs verglichenen LoRA-Adaptern: https://opairs-systems.com/insights/opairs-sql-agent-datenbanken-adapter-vergleich
Open Source auf GitHub
Der Dienst ist Open Source und steht unter der Apache-2.0-Lizenz auf GitHub: https://github.com/OPAIRS/opairs-forecast. Dort liegen Code, Tests, Docker-Beispiel, der Benchmark zum Nachrechnen und die Dokumentation auf Deutsch und Englisch. Verwendet werden ausschließlich Bibliotheken und Modellgewichte, deren Lizenzen eine solche Nutzung zulassen; die Gewichte selbst werden nicht mitgeliefert. Der Dienst ist eine eigene Implementierung und kein Wrapper um bestehende Prognose-Frameworks. Wer ihn prüfen, nachbauen oder weiterentwickeln möchte, kann das ohne Abhängigkeit von OPAIRS tun.
Gesucht: echte Zeitreihen aus der Fertigung
Öffentliche Datensätze zeigen, dass die Modellwahl funktioniert. Ob sie auf realen Produktionsdaten trägt, zeigen nur reale Produktionsdaten. Deshalb sucht OPAIRS Partner, die den Dienst auf eigenen Zeitreihen prüfen möchten: Verbrauch, Bedarf, Energie oder Maschinenkennzahlen, idealerweise mit mindestens zwei Jahren Historie je Artikel oder Maschine. Die Verarbeitung bleibt lokal beziehungsweise unter der Kontrolle des Partners. Rückmeldungen und Beiträge sind auch direkt über das Repository willkommen. Interessant sind gerade die Fälle, in denen der Dienst keine validierte Prognose liefern kann: Sie zeigen, wo bessere Daten, mehr Kontext oder zusätzliche Modelle nötig sind.
Für technische Zusammenarbeit, gemeinsame Validierung oder Industrieprojekte: office@opairs-systems.com
Weitere Insights
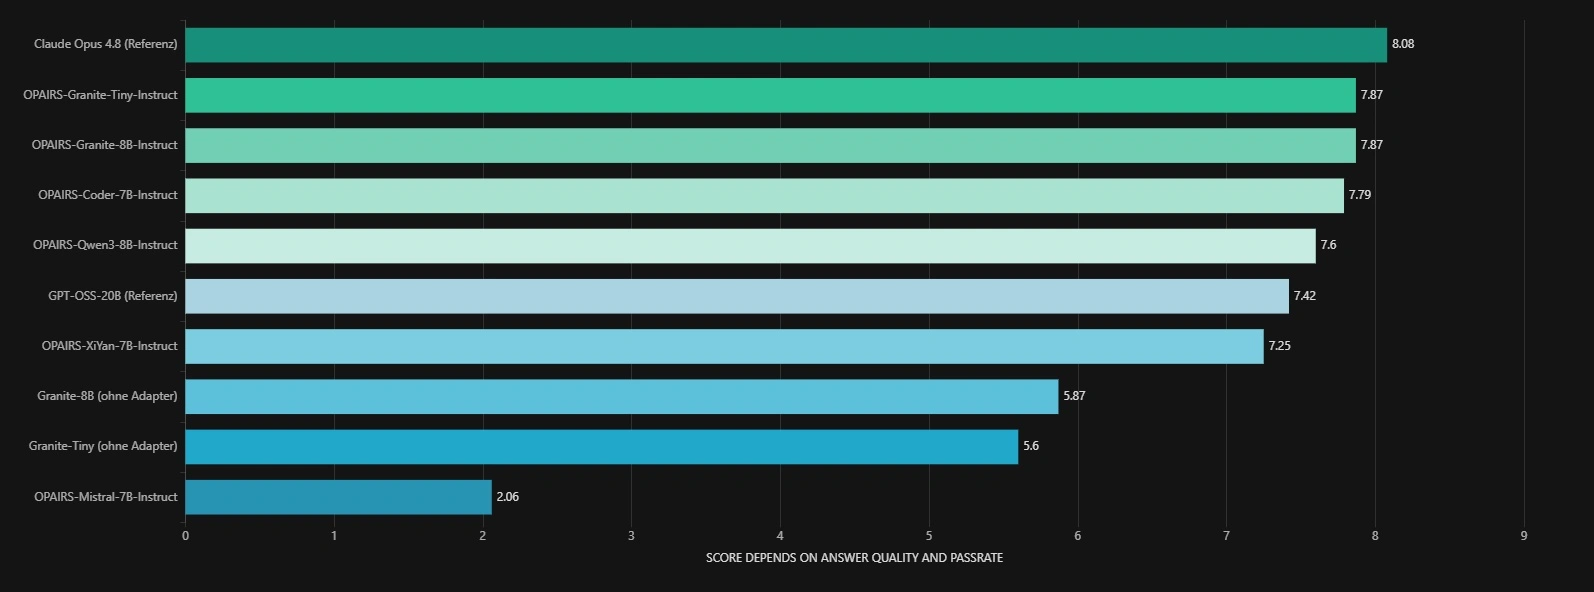
OPAIRS SQL-Agent: Sechs LoRA-Adapter für industrielle Datenbanken im Vergleich
Sechs LoRA-Adapter, ein 26-Fragen-Katalog aus PostgreSQL-, T-SQL- und Apache-Iceberg-Datenbanken, zwei externe Referenzmodelle: OPAIRS hat den SQL-Agenten systematisch evaluiert. Zwei Granite-Adapter liegen an der Spitze. Für den produktiven Einsatz entscheidet am Ende aber nicht nur die Antwortqualität, sondern auch Geschwindigkeit, Speicherbedarf, Parallelität und der verfügbare Kontext aus ERP-, MES-, PLM- und weiteren industriellen Systemen.
Beitrag lesen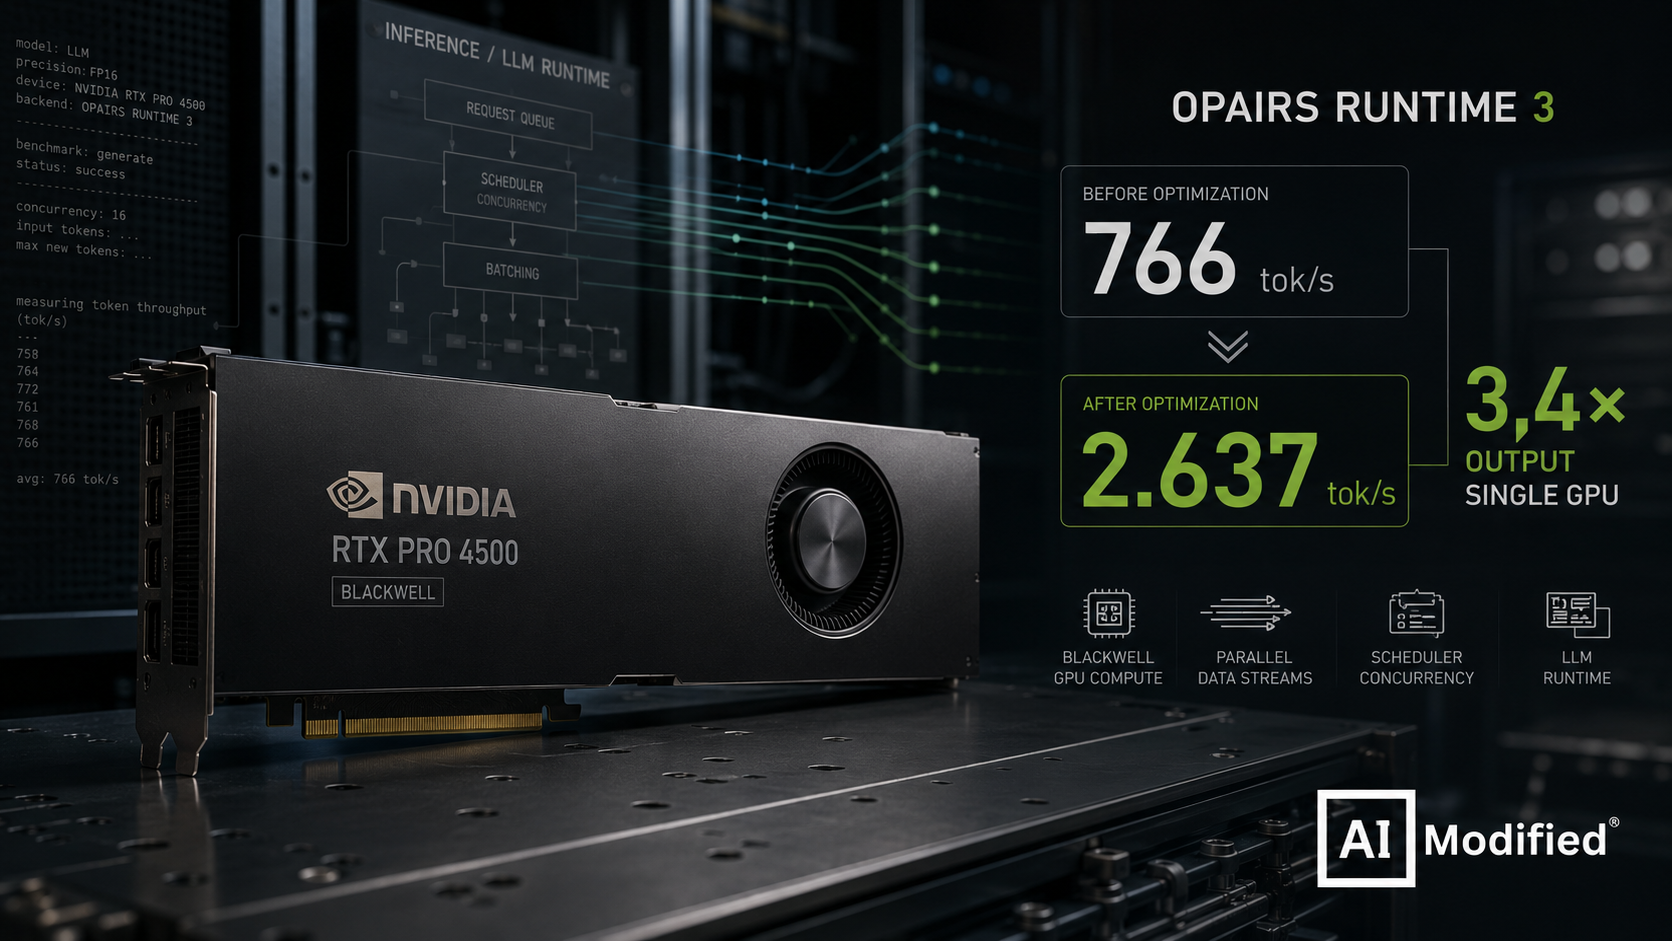
RTX PRO 4500 Blackwell: 3,4-facher LLM-Durchsatz durch Runtime-Optimierung
Gleiche GPU, gleiches Hauptmodell, bis zu 3,4-facher Output: OPAIRS Runtime 3 erhöht den Durchsatz von GPT-OSS-20B auf der RTX PRO 4500 Blackwell auf bis zu 2.637 Token/s. Gleichzeitig zeigen die Tests, warum Qwen3.8-27B den Produktionsstack vorerst nicht übernimmt.
Beitrag lesen